
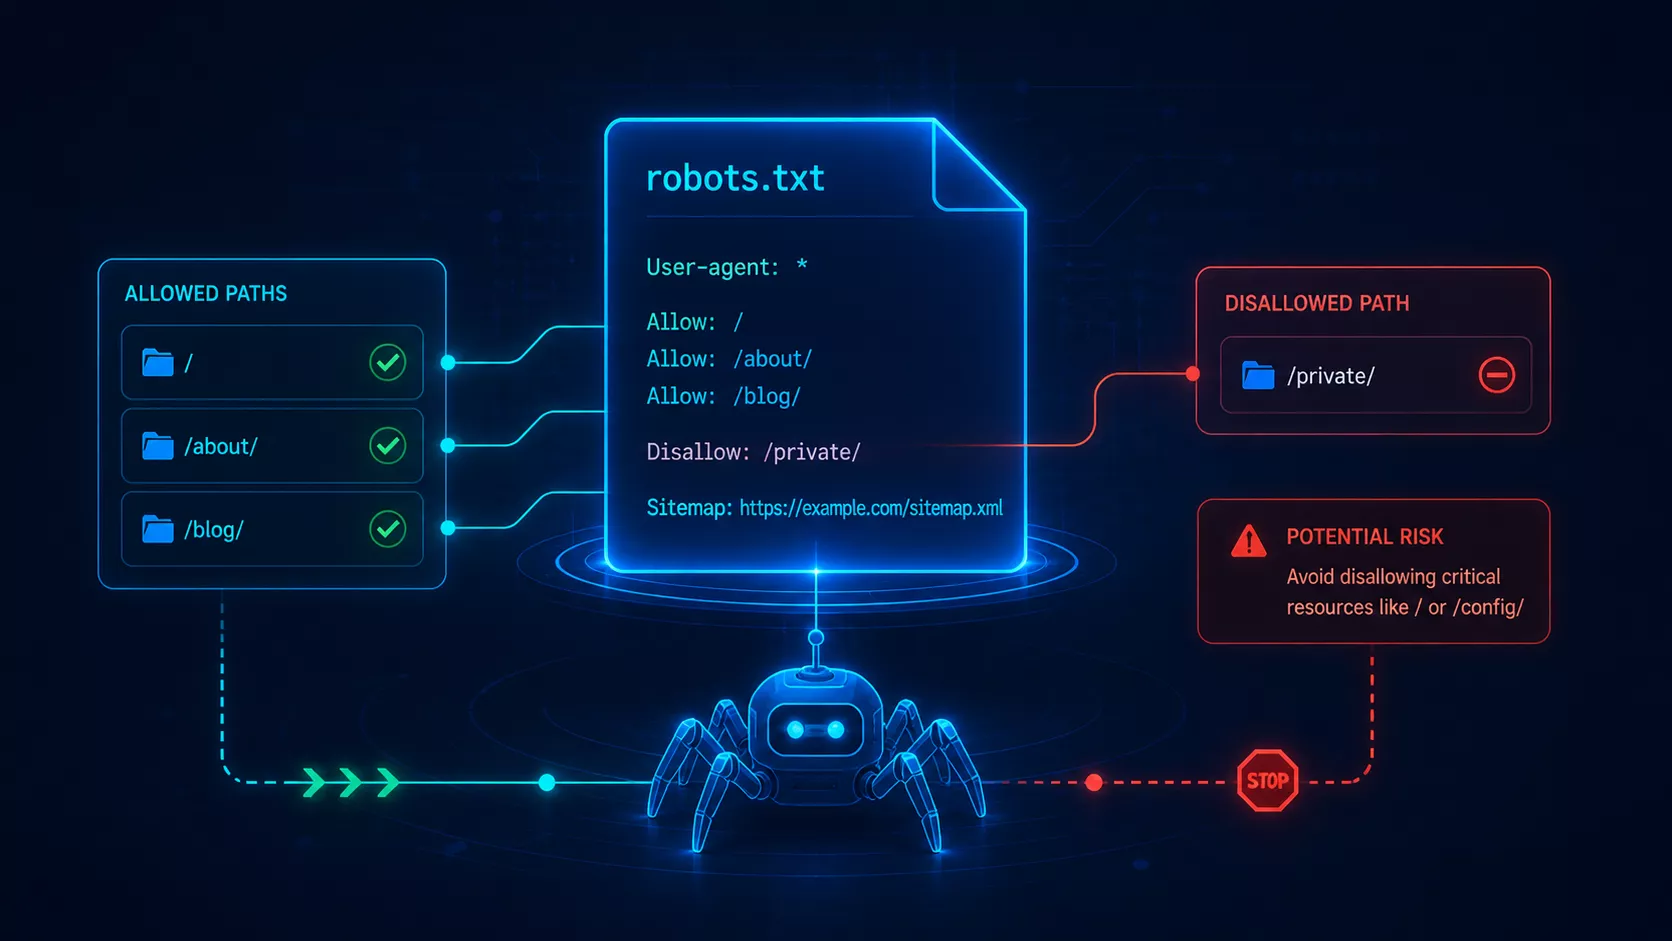
O que mede este check
Este check verifica se o ficheiro robots.txt Existe, responde corretamente e não contém regras que bloqueiem por erro partes importantes do site.
A localização padrão do ficheiro é sempre a raiz do domínio:
https://exemplo.com/robots.txtA AISEO interpreta-o como um sinal inicial de rastreio. Não decide por si só a qualidade do site, mas pode impedir que os bots cheguem ao conteúdo.
Por que importa em AISEO
Robots.txt é pequeno, mas pode fazer muito dano. Uma linha como Disallow: / Pode bloquear o rastreio completo do site se for deixado ativo em produção.
Para motores de pesquisa, crawlers técnicos e sistemas de IA, robôs.txt costuma ser um dos primeiros sinais consultados antes de rastrear uma web.
- Um bloqueio global pode impedir que os bots acedam à web.
- Regras herdadas de staging podem ficar ativas em produção.
- Bloquear recursos CSS ou JS pode dificultar a interpretação da página.
Como verificar o passo a passo
Abre o /robots.txt
Aceda manualmente ao URL do ficheiro e verifique que responde com o estado válido. O habitual é encontrá- lo na raiz do domínio.
Rever bloqueios globais
Procura regras como Disallow: /. Em produção, esta directiva só deveria existir se quer realmente bloquear todo o sítio.
Verifique as pastas sensíveis
Valida que não sejam bloqueadas secções públicas importantes, categorias, artigos, produtos ou páginas de conversão.
Rever o sitemap declarado
Se o ficheiro incluir uma linha Sitemap:, verifica que aponta um sitemap real, acessível e coerente com o domínio.
Exemplo de robots.txt correto
Um robô.txt básico pode permitir o rastreio geral e declarar o sitemap principal da web.
User- agent: *
Allow: /

Sitemap: https://exemplo.com/sitemap.xml- O ficheiro responde corretamente na raiz do domínio.
- Não bloqueia o site completo por acidente.
- Declara um sitemap válido quando existe.
Erros frequentes
- Deixar Disallow: / ativo após publicar a web.
- Bloquear as pastas que contêm conteúdo público importante.
- Declarar um sitemap que devolve erro ou pertence a outro domínio.
- Usar robôs.txt como se fosse uma medida de segurança privada.
- Bloquear recursos necessários para renderizar corretamente a página.
Checklist final
- O ficheiro robots.txt existe ou responde de forma controlada.
- Não há bloqueio global acidental do site.
- Não se bloqueiam secções públicas estratégicas.
- O sitemap declarado, se existir, é válido e acessível.
- As regras são simples, compreensíveis e coerentes com a arquitetura real.